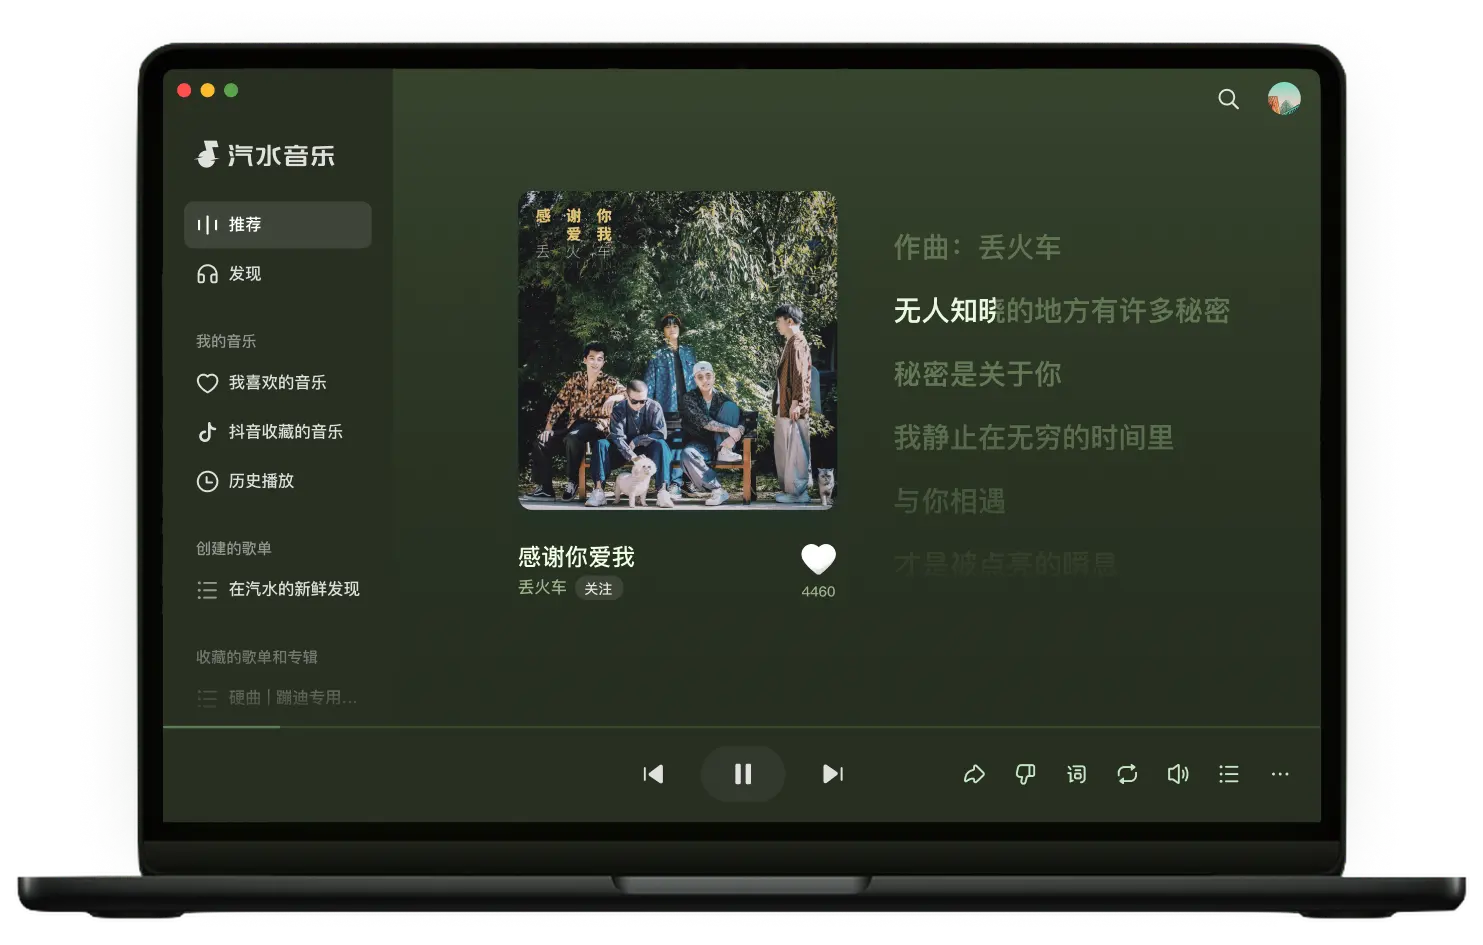
你有没有过这样的体验:打开汽水音乐,随手点开推荐流里的第一首歌,结果一连听了十几首,每首都恰到好处地落在你的审美点上。你可能会想——它怎么这么懂我?
这背后是一套持续学习的推荐系统。今天我们不谈深奥的公式,而是从产品设计的角度,聊聊汽水音乐的推荐流是如何一步步“学会”听懂你的。
一、从一次点击开始:行为埋点
推荐系统的第一步是观察。当你使用汽水音乐时,每一个动作都在产生信号:
- 显式反馈:点亮红心、收藏歌单、分享给朋友——这些是明确的“喜欢”信号。
- 隐式反馈:完整听完一首歌、循环了三次,还是在第 15 秒就切掉——这些行为同样在说明你的偏好。
- 上下文信息:你在什么时间听(深夜还是通勤)、用什么设备(手机还是电脑)、在什么场景下打开,都会作为辅助特征被记录下来。
这些数据经过清洗和结构化后,会进入统一的行为序列模型。它不是简单统计“你听了多少首流行歌”,而是试图理解你听歌的顺序和节奏——比如你通常会在两首快歌之后切到一首慢歌,这种模式也会被捕捉到。
好的推荐不是“猜中你下一首想听什么”,而是“在你还没意识到自己想听什么之前,就把它放到你面前”。
二、兴趣向量:把你的口味变成一串数字
接下来,系统会把你的行为映射到一个高维空间里,形成一个兴趣向量。你可以把它想象成一份“音乐口味指纹”:
- 维度可能包括节奏快慢、人声类型、编曲风格、情绪色彩、年代偏好等;
- 每个维度都有一个权重,权重随你的行为动态调整;
- 你跳过一首歌,对应维度的权重轻微下降;你循环播放,权重则上升。
与此同时,每首歌也会被预先计算出一个内容向量。推荐引擎要做的,就是找到与你兴趣向量最接近的那些歌曲。
三、不只是“相似”:多样性与探索
如果推荐系统只做“相似匹配”,你很快就会陷入信息茧房——听来听去都是同一种风格。汽水音乐在推荐流里引入了两个关键机制:
1. 多样性重排
即使系统找出了 100 首与你兴趣向量高度接近的歌,也不会直接按相近程度推给你。它会做重排:在相邻的几首之间控制风格差异,让一次连续的收听里既有熟悉的安全区,也有新鲜的试探。
2. 探索位
推荐流里始终保留一部分“探索位”,用来放系统认为你可能喜欢但还没听过的歌。这些歌的初始权重不高,但一旦被你完整听完,兴趣向量就会被迅速修正。
四、冷启动:第一次打开时它在想什么
新用户没有历史行为,系统会先用两样东西兜底:一是地区与语言的先验分布,二是热门与新歌的混合池。这就是为什么刚注册时听到的曲子往往比较大众——它在用最快的方式试探你的口味边界。
如果你用抖音账号登录,系统还可以参考你在抖音侧的公开音乐行为,冷启动的准确度会明显更高。这也是我们推荐抖音一键登录的原因之一。
五、你仍然拥有控制权
再聪明的模型也需要反馈边界。汽水音乐提供了几处直接干预的入口:
- 对不感兴趣的歌曲点“不感兴趣”,这条信号会被优先处理;
- 在设置里重置推荐数据,可以让兴趣向量重新开始学习;
- 关闭个性化推荐后,首页会退回更通用的编辑推荐流。
推荐系统的目标从来不是替你决定听什么,而是把“找到一首刚好想听的歌”这件事的成本降到最低。你越自然地使用,它就越接近这个目标。
本文为产品机制科普,具体算法细节以汽水音乐官方说明为准。